VLA-модели: ИИ, который видит, понимает команду и управляет роботом
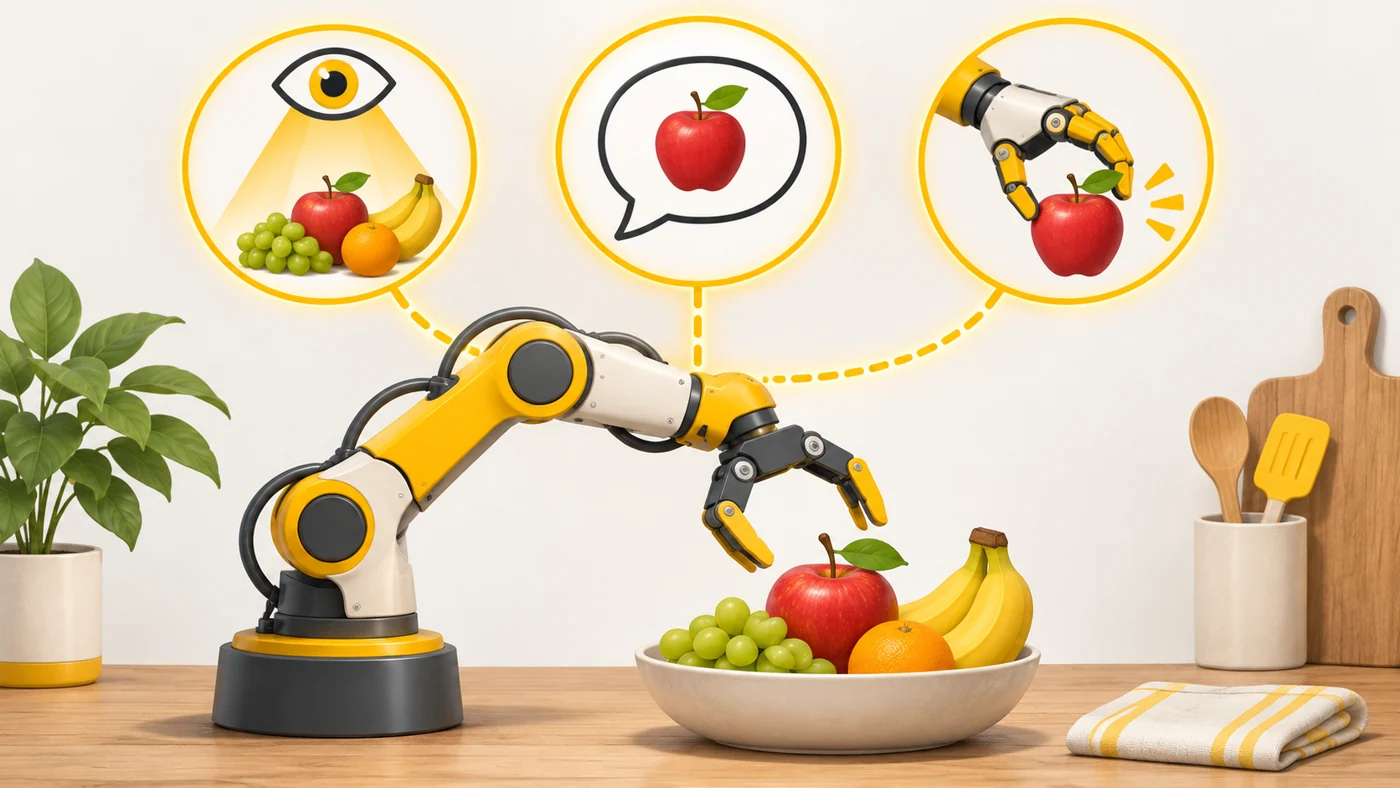
Модель «зрение-язык-действие» (VLA, Vision-Language-Action) - это нейросеть, которая одновременно анализирует изображение с камер, понимает текстовую или голосовую команду и выдает конкретные действия для робота: как двигать руку, захват или колеса.
Простыми словами
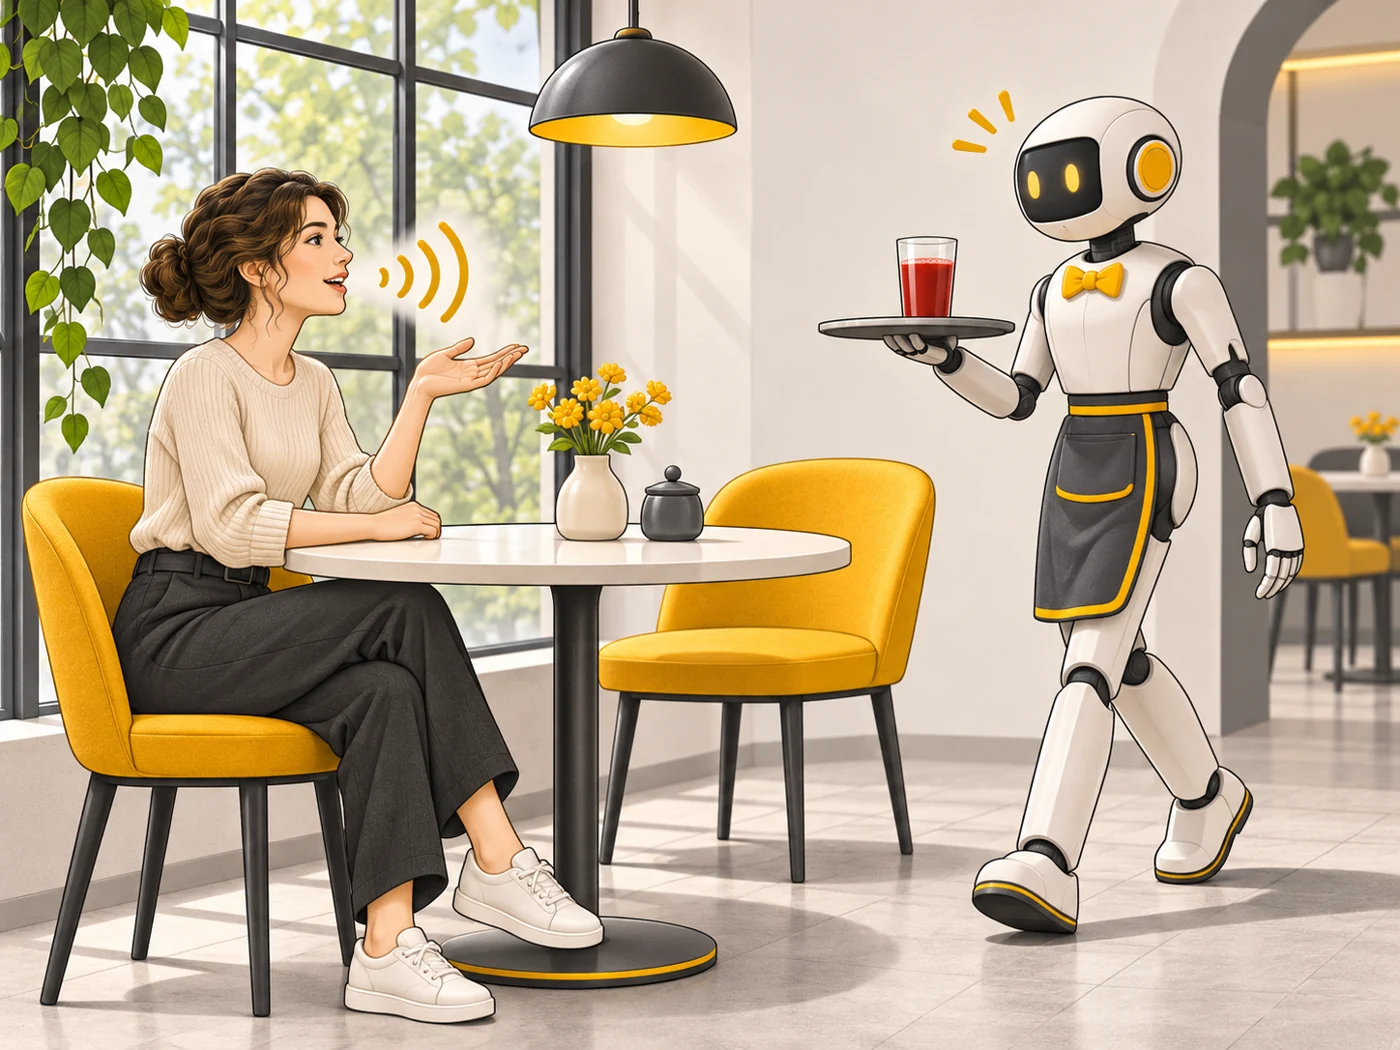
Представь официанта, которому говорят: «Принесите, пожалуйста, тот красный сок у окна». Он должен увидеть стол, понять слова и сделать правильные движения. VLA-модель делает эти три вещи вместе: глаза (vision), понимание слов (language) и руки (action) в одном «мозге».
Как это работает
- Камеры робота передают изображение в модель.
- Модель получает команду человека обычным языком.
- Она сопоставляет слова с тем, что видит: «яблоко» - вот этот красный предмет.
- На выходе модель генерирует не текст, а последовательность движений - как языковая модель генерирует слова.
- Робот выполняет движения, камера видит новое состояние - и цикл повторяется.
Где ты это увидишь
В исследовательских лабораториях и компаниях, которые разрабатывают гуманоидов и роботов-помощников. Такие модели обучают на больших наборах записей роботов и на видео с людьми. Это один из основных подходов в современной робототехнике.
Важно ли это при выборе
На покупку пока не влияет. Но этот термин объясняет, почему прогресс в роботах вдруг ускорился: те же идеи, которые сделали чат-ботов умными, теперь применяют к движениям. Если интересуешься робототехникой как профессией - стоит следить за этой темой.
Мифы
- Миф: VLA-модель - это просто чат-бот в роботе. На самом деле: Она выдает не текст, а команды для моторов, и учится на данных движений.
- Миф: Одна модель уже умеет все. На самом деле: Пока роботы на VLA хорошо выполняют знакомые типы задач, но в новых условиях часто ошибаются.
Частые вопросы
Чем VLA отличается от мультимодальной модели?
Мультимодальная отвечает текстом, VLA - движениями робота.
На чем обучают VLA?
На записях роботов, выполняющих задачи, демонстрациях людей и видео.
Работает ли VLA на самом роботе?
Часто да, на бортовом компьютере, потому что задержка через интернет мешает движениям.
Связанные термины
Воплощенный ИИ, Мультимодальная модель, Компьютерное зрение, Гуманоидный робот