Мультимодальная модель: ИИ, который видит, слышит и читает
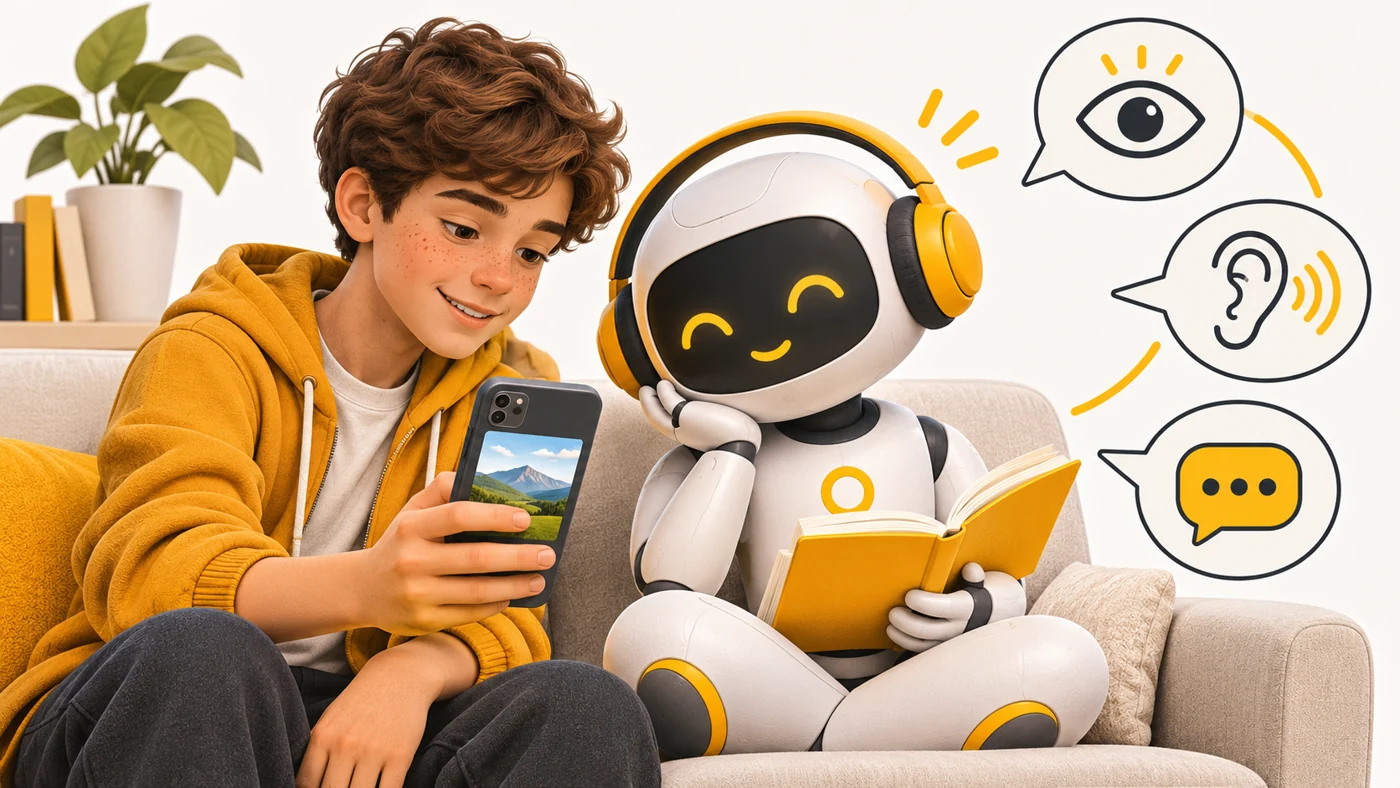
Мультимодальная модель - это ИИ, который работает с несколькими типами данных одновременно: текстом, изображениями, звуком, видео. Ты можешь показать ей фото и спросить голосом, а она ответит текстом или голосом.
Простыми словами
Первые чат-боты были как собеседник по переписке: только текст. Мультимодальная модель - как друг, который сидит рядом: ты показываешь ему фото, включаешь песню, тычешь пальцем в схему - и он понимает все вместе. «Модальность» - это просто тип информации: текст, картинка, звук.
Как это работает
- Каждый тип данных превращают в числа: текст - в токены, фото - во фрагменты-«патчи», звук - в кусочки спектра.
- Модель обучена на парах данных: фото с описаниями, видео с субтитрами, звук с текстом.
- Поэтому она «понимает», как слова связаны с тем, что видно и слышно.
- Ты можешь сочетать типы в одном запросе: «что не так с моим решением?» плюс фото тетради.
- Некоторые модели отвечают не только текстом, но и голосом или картинкой.
Где ты это увидишь
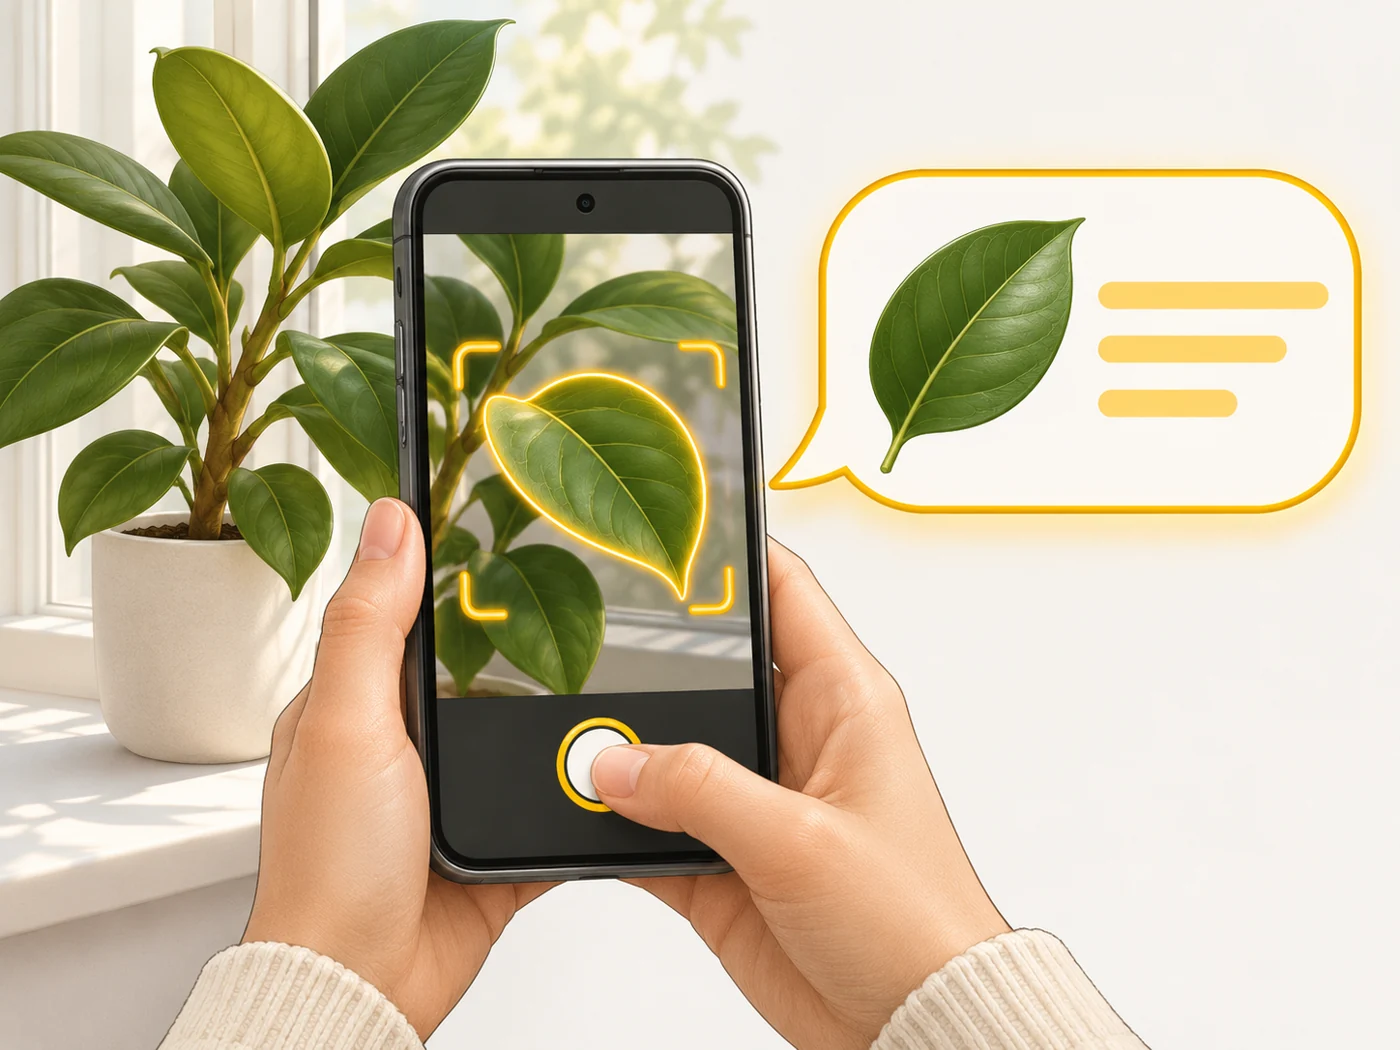
Почти все ведущие ИИ-ассистенты уже мультимодальные: можно сфотографировать меню и попросить перевод, навести камеру на растение и спросить название, поговорить голосом. В смартфонах это функции вроде поиска обведением (Circle to Search) и разговоров с ассистентом через камеру.
Важно ли это при выборе
Да, потому что это одна из самых полезных вещей ИИ в повседневности. Для такой работы важны хорошая камера, микрофоны и быстрый интернет или мощный NPU. Но помни: показывая модели фото, ты отправляешь его на сервер. Документы и чужие лица я бы не фотографировал для ИИ без нужды.
Мифы
- Миф: Модель «видит» так же, как человек. На самом деле: Она анализирует пиксели по выученным закономерностям и может ошибиться там, где человек не ошибся бы.
- Миф: Мультимодальность - только про фото. На самом деле: Это также звук, видео, документы, графики и даже данные датчиков.
Частые вопросы
Может ли модель прочитать рукописный текст?
В основном да, если почерк разборчивый и фото четкое.
Работает ли это без интернета?
Простые функции на флагманах - да, сложные - в основном через облако.
Понимает ли модель видео?
Современные модели умеют анализировать видео, разбивая его на кадры и звук.
Связанные термины
Большая языковая модель, Компьютерное зрение, Распознавание речи, Модели «зрение-язык-действие»